Đọc xu hướng khu vực dễ hơn: nên chọn bảng tổng hợp hay bảng chi tiết OK9?
Ba tình huống đọc dữ liệu trong bối cảnh khu vực
Khi tra cứu thông tin xổ số và bảng thống kê trên OK9, câu hỏi đầu tiên không phải là bảng nào nhiều dữ liệu hơn mà là bạn muốn kiểm tra điều gì. Một người đọc theo dõi xu hướng mô tả của vài khu vực sẽ cần cách xem khác với người muốn mở lại từng bản ghi để đối chiếu.
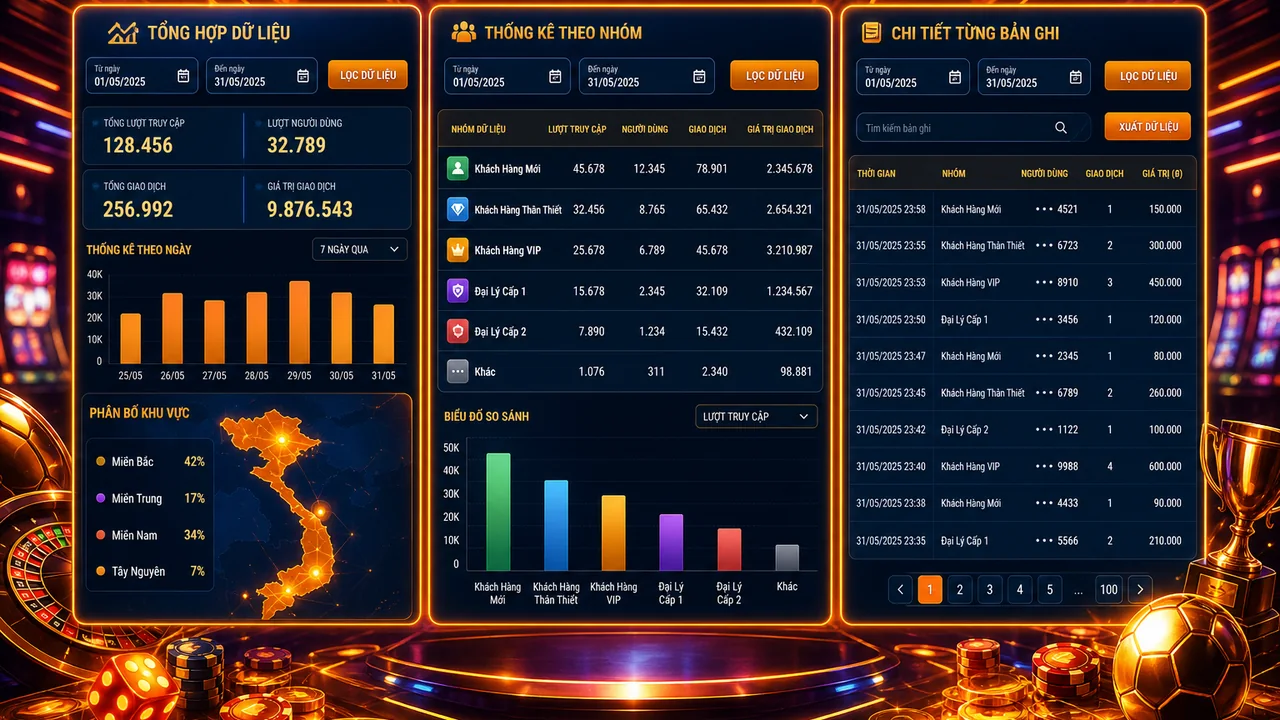
Bài nghiên cứu này dùng ba bộ dữ liệu mô phỏng, mỗi bộ có một cấp độ chi tiết. Tình huống A chỉ cần nhìn số lượt xuất hiện theo khu vực. Tình huống B cần so sánh các nhóm ngày hoặc vùng. Tình huống C cần xem từng dòng dữ liệu, thời điểm ghi nhận và trường liên quan. Các ví dụ chỉ đánh giá mức phù hợp của cấu trúc, không xếp hạng khả năng thắng.
Tình huống A: chọn bảng tổng hợp để xem nhanh
Giả sử độc giả muốn biết trong một phạm vi khu vực, nhóm nào được nhắc đến thường xuyên hơn trong tập dữ liệu mô phỏng. Bảng tổng hợp có thể chỉ gồm bốn trường: khu vực, số bản ghi, nhóm chính và khoảng thời gian. Với câu hỏi ngắn, cấu trúc này giúp giảm nhiễu và tạo một khung nhìn nhanh.
Điểm mạnh của bảng tổng hợp là tốc độ đọc. Bạn có thể phát hiện sự khác biệt về số lượng giữa các khu vực mà không cần mở từng dòng. Tuy nhiên, bảng này không trả lời tốt câu hỏi “mỗi con số đến từ bản ghi nào?”. Vì vậy, không nên dùng cấp độ tổng hợp để dự đoán kỳ sau hoặc suy luận nguyên nhân chưa được ghi nhận.
Tình huống B: bảng theo nhóm cho mục tiêu so sánh
Nếu câu hỏi chuyển thành “các nhóm trong từng khu vực khác nhau ra sao?”, bảng theo nhóm là lựa chọn cân bằng hơn. Bộ dữ liệu mô phỏng có thể gồm sáu trường: khu vực, nhóm thời gian, nhãn phân loại, số bản ghi, tỷ lệ trong mẫu và ghi chú phạm vi. Các trường này đủ để đặt hai hoặc nhiều nhóm cạnh nhau.
Ví dụ, nhóm “buổi sáng” và “buổi tối” được trình bày trong cùng một cấu trúc, nhưng kết luận chỉ nên mô tả sự khác nhau trong mẫu đã chọn. Một nhãn có số bản ghi cao hơn không đồng nghĩa với kết quả tốt hơn. Độc giả nên kiểm tra phạm vi thời gian, cách gom nhóm và số dòng trước khi diễn giải.
Tình huống C: bảng từng bản ghi để kiểm tra ngược
Khi cần truy lại một con số, bảng từng bản ghi phù hợp nhất. Trong mô phỏng, bảng này có thể chứa mười trường: mã dòng, khu vực, ngày ghi nhận, nhãn nhóm, giá trị hiển thị, nguồn trong bộ dữ liệu, trạng thái đối chiếu, ghi chú và hai trường phân loại phụ. Nhiều trường hơn đồng nghĩa với nhiều điểm kiểm tra hơn, nhưng cũng khiến việc đọc nhanh khó hơn.
Khả năng kiểm tra ngược là tiêu chí quan trọng. Độc giả có thể lọc theo khu vực, mở từng dòng, rồi đối chiếu với bảng theo nhóm hoặc bảng tổng hợp. Cách làm này hữu ích khi phát hiện số liệu lệch giữa hai màn hình. Dù vậy, chi tiết cao không phải bằng chứng cho kết quả tốt hơn; nó chỉ làm rõ cách một con số được tạo trong bộ dữ liệu mô phỏng.
Ma trận chọn cấp độ bảng trên OK9
| Mục tiêu đọc | Câu hỏi chính | Số trường gợi ý | Khả năng kiểm tra ngược |
| Tổng quan | Khu vực nào có nhiều bản ghi hơn? | 3–4 | Thấp |
| So sánh nhóm | Các nhóm trong cùng phạm vi khác thế nào? | 5–7 | Trung bình |
| Đối chiếu dòng | Con số này xuất phát từ bản ghi nào? | 8–10 | Cao |
Ma trận cho thấy lựa chọn hợp lý phụ thuộc vào user job, không phụ thuộc vào việc bảng dài hay ngắn. Nếu chỉ cần mô tả xu hướng trong một phạm vi khu vực, bắt đầu bằng bảng tổng hợp. Nếu cần so sánh cách chia nhóm, dùng bảng theo nhóm. Chỉ mở bảng từng bản ghi khi có nhu cầu kiểm tra cụ thể.
Kết luận và thuật ngữ cần nhớ
Cách trả lời cho truy vấn “nên chọn bảng tổng hợp hay bảng chi tiết OK9” là: chọn bảng theo câu hỏi, phạm vi và mức kiểm tra cần thiết. Bảng tổng hợp phù hợp với việc quét nhanh; bảng theo nhóm hỗ trợ so sánh; bảng từng bản ghi phục vụ kiểm tra ngược. Ba cấp độ có thể bổ sung cho nhau trong một quy trình đọc dữ liệu khu vực.
Một số thuật ngữ hữu ích gồm “phạm vi mẫu” là tập dữ liệu được chọn để quan sát, “số trường” là số cột mô tả mỗi dòng, còn “kiểm tra ngược” là khả năng đi từ kết luận về bản ghi gốc. Các thuật ngữ này giúp đọc thông tin trên OK9 rõ ràng hơn, nhưng không biến bảng thống kê thành công cụ dự đoán kỳ tiếp theo.